OTUS Pазработчик BigData. Модуль 4 из 5
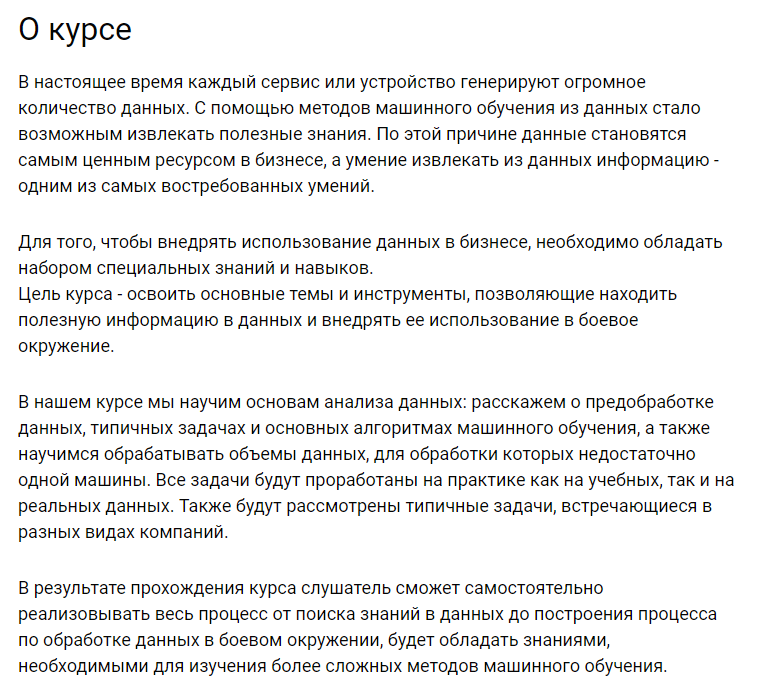
Большую часть времени любого разработчика процессов анализа данных занимает разработка самого процесса по преобразованию данных на разных этапах. Предполагаются этапы сбора, очистки, агрегации данных, построения модели и предсказания характеристик.
В четвертом модуле рассматриваются возможности построения надежных процессов преобразования данных.В более крупных компаниях данные превышают возможности одной типичной разработческой машины. Появляется потребность работы с алгоритмами, обрабатывающими данные в потоке, а также с кластером.
В четвертом модуле разбираются процессы преобразования данных, слои данных, потоки данных и различные способы хранения и преобразования таких данных на кластере. Разберем возможности построения моделей на кластере. К концу модуля слушатели смогут уверенно использовать стек технологий Hadoop: писать задачи на MapReduce с использованием Java или Hadoop Streaming, использовать Hive и Spark для быстрого преобразования данных, расчета статистик, построения моделей на кластере.
Занятие 25: Процесс CRISP-DM. Выбор хранилища, запросы к базе (Реляционная, нереляционная). Большие данные и параллельные вычисления.
Кластер, hdfs, запросы к hdfs. Map Reduce, Java, Python, Необходимость в кластерных вычислениях. Парадигма MapReduce. Инструменты работы с большими данными. Hadoop, Spark, обзор других компонентов экосистемы. Развертывание кластера Hadoop локально для выполнения учебных примеров. Выполнение учебных примеров на кластере.
ДЗ
Настройка окружения для локальной работы с кластером. Выполнение на локальном кластере набора учебных задач.
Занятие 26: Vowpal Wabbit для обучения линейных моделей на одной машине
Занятие 27: MapReduce на Java, Hadoop Streaming - MapReduce на Python, bash
ДЗ
Реализация алгоритма с использованием MapReduce.
Занятие 28: Пайплайны. Способы выстроить поток задач, обеспечить выполнение. Отказоустойчивость, мониторинг.
Занятие 29: Слои данных для оптимизации процессов использования данных. Hive.
ДЗ
Реализация алгоритма с использованием Hive.
Занятие 30: Организация хранения данных для решения задач машинного обучения
Занятие 31: Spark
Spark как инструмент быстрого доступа к данным. Spark как инструмент для машинного обучения.
ДЗ
Реализация алгоритма с использованием Spark.
Занятие 32: Обзор решений для аналитики больших данных
Vertica, Clickhouse. Основные преимущества и недостатки, для хранения и обработки данных.
Агрегация, управление, эксперименты, анализ, визуализация и BI
Скачать: Оформить VIP Подписку и открыть доступ к этой и другим темам.
Большую часть времени любого разработчика процессов анализа данных занимает разработка самого процесса по преобразованию данных на разных этапах. Предполагаются этапы сбора, очистки, агрегации данных, построения модели и предсказания характеристик.
В четвертом модуле рассматриваются возможности построения надежных процессов преобразования данных.В более крупных компаниях данные превышают возможности одной типичной разработческой машины. Появляется потребность работы с алгоритмами, обрабатывающими данные в потоке, а также с кластером.
В четвертом модуле разбираются процессы преобразования данных, слои данных, потоки данных и различные способы хранения и преобразования таких данных на кластере. Разберем возможности построения моделей на кластере. К концу модуля слушатели смогут уверенно использовать стек технологий Hadoop: писать задачи на MapReduce с использованием Java или Hadoop Streaming, использовать Hive и Spark для быстрого преобразования данных, расчета статистик, построения моделей на кластере.
Занятие 25: Процесс CRISP-DM. Выбор хранилища, запросы к базе (Реляционная, нереляционная). Большие данные и параллельные вычисления.
Кластер, hdfs, запросы к hdfs. Map Reduce, Java, Python, Необходимость в кластерных вычислениях. Парадигма MapReduce. Инструменты работы с большими данными. Hadoop, Spark, обзор других компонентов экосистемы. Развертывание кластера Hadoop локально для выполнения учебных примеров. Выполнение учебных примеров на кластере.
ДЗ
Настройка окружения для локальной работы с кластером. Выполнение на локальном кластере набора учебных задач.
Занятие 26: Vowpal Wabbit для обучения линейных моделей на одной машине
Занятие 27: MapReduce на Java, Hadoop Streaming - MapReduce на Python, bash
ДЗ
Реализация алгоритма с использованием MapReduce.
Занятие 28: Пайплайны. Способы выстроить поток задач, обеспечить выполнение. Отказоустойчивость, мониторинг.
Занятие 29: Слои данных для оптимизации процессов использования данных. Hive.
ДЗ
Реализация алгоритма с использованием Hive.
Занятие 30: Организация хранения данных для решения задач машинного обучения
Занятие 31: Spark
Spark как инструмент быстрого доступа к данным. Spark как инструмент для машинного обучения.
ДЗ
Реализация алгоритма с использованием Spark.
Занятие 32: Обзор решений для аналитики больших данных
Vertica, Clickhouse. Основные преимущества и недостатки, для хранения и обработки данных.
Агрегация, управление, эксперименты, анализ, визуализация и BI
Скачать: Оформить VIP Подписку и открыть доступ к этой и другим темам.
Скрытое содержимое доступно для зарегистрированных пользователей!